·9 min de lectura
Qué puede y qué no puede hacer la IA con los documentos aduaneros
Todos los proveedores de este mercado dicen ya que su software lee sus documentos. Es cierto, hasta cierto punto. Esta es la versión honesta: qué resuelve realmente la lectura automática, dónde falla de forma demostrable, y por qué la manera en que un sistema expresa su duda importa más que la frecuencia con la que acierta a la primera.
¿Qué significa en realidad que un software lea sus documentos?
Leer documentos no es una operación sino tres, y fallan de maneras distintas. La primera es la extracción: deducir de un pdf o de un escaneo qué caracteres hay en la página y qué campo forman. Que la página diga EUR 14.320,00 es una cosa. Que se trate del total de la factura y no del subtotal o del importe del flete es otra. La segunda es la clasificación: determinar qué tipo de documento tiene delante y qué papel cumple cada bloque de texto. Un albarán, una factura proforma y una factura comercial se parecen, y las diferencias están en detalles que una maquetación coloca arriba y otra abajo. El tercer paso es el que más trabajo ahorra en la práctica: cotejar los documentos entre sí. ¿Coincide el número de bultos de la lista de empaque con las líneas de la factura? ¿Está el peso bruto del conocimiento de embarque cerca del de la lista de empaque? ¿Remite el certificado al mismo número de envío? Ese tercer paso ya no es un problema de lectura, es cálculo y comparación, y ahí precisamente una máquina es incansable como nadie lo es a las cuatro de la tarde.
¿Dónde funciona la lectura automática sin problemas?
En la aburrida mayoría. Una factura comercial generada por el ERP de un proveedor habitual, enviada como pdf con una capa de texto real, con los mismos encabezados en los mismos sitios cada mes, es casi un fichero estructurado que por casualidad viaja como documento. Lo mismo vale para las listas de empaque salidas de un WMS y para los certificados estándar que una autoridad emite sobre una plantilla fija. El patrón detrás de esos casos no es un documento bonito, es la repetición. Con un remitente que ve cada semana, el sistema sabe dónde está el incoterm, que la divisa aparece arriba a la derecha y no junto al importe, que Ref. significa el número de pedido en este cliente y el número de contenedor en otro. Cuanto más vuelve un remitente, menos queda por adivinar. Esa es también la frontera honesta de la promesa. La lectura funciona bien sobre el tráfico que ya conoce, y ese tráfico ocupa en volumen la mayor parte de sus días. No es la parte donde sus declaraciones se atascan, porque ahí no se le va el tiempo. El tiempo se le va en las excepciones.
¿Dónde falla de forma demostrable?
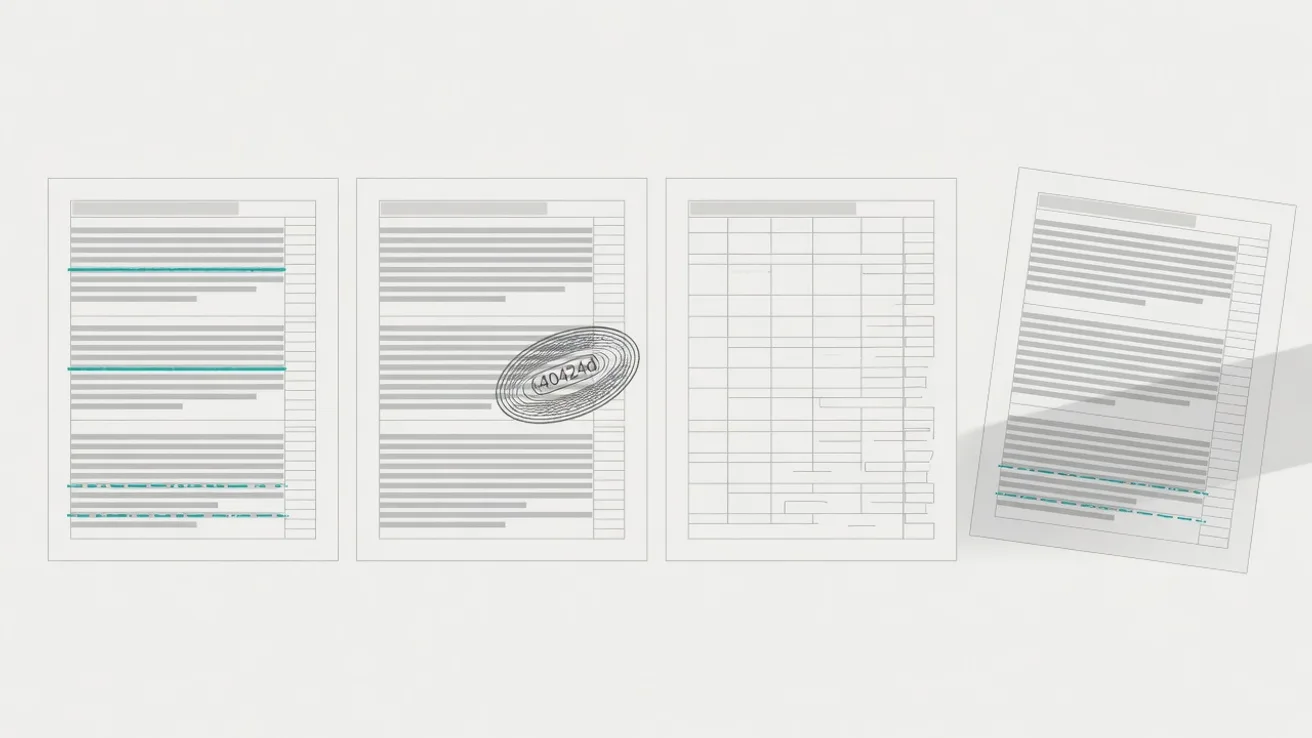
La lista es concreta y la reconoce cualquiera que presente declaraciones. La escritura a mano, por ejemplo un peso añadido con bolígrafo en el muelle, o una firma con una fecha debajo que es lo que hace válido el certificado. Un documento sellado que un día fue un fax, luego se fotocopió, se escaneó y se reenvió, con el sello cayendo justo sobre el texto que necesita. Una lista de empaque de once páginas cuyo recuento de líneas no cuadra con lo que dice la factura. Una tabla que continúa tras un salto de página, sin repetir los encabezados, donde la última línea de la página tres y la primera de la cuatro son en realidad una sola línea. Documentos que mezclan dos idiomas, con una descripción en chino y otra en inglés debajo que no dice lo mismo. Y la foto: una página captada de lado con un teléfono, con una sombra sobre la columna derecha y un pliegue atravesando el importe. Lo que comparten estos casos es que no son solo un poco más difíciles. Son aquellos en los que un sistema obligado a dar una respuesta rellena algo plausible. Un campo vacío lo ve todo el mundo. Un campo mal rellenado pero pulcro, nadie.
Por qué una puntuación de confianza no equivale a acertar
Una puntuación dice hasta qué punto una respuesta encaja con los patrones que el modelo ya ha visto. Esa es una pregunta distinta de si la respuesta es cierta. Una factura impresa con pulcritud, con un importe situado en la columna equivocada, produce una puntuación alta sobre ese importe erróneo justamente, porque la forma es correcta. La puntuación mide la forma, no la realidad. Ahí está la asimetría en torno a la cual hay que diseñar. Un campo marcado como incierto le cuesta veinte segundos y acaba bien. Un campo equivocado con alta confianza entra en el expediente, pasa ante el compañero que se fía, entra en la declaración y termina en la aduana. Equivocarse con seguridad sale más caro que dudar. Por eso la pregunta interesante no es con qué frecuencia acierta un sistema, sino si sabe cuándo no sabe, y qué hace entonces. Un lector que ante la duda prefiere no rellenar nada y dejar el campo abierto resulta más útil que uno que siempre rellena algo. Lo primero cuesta un gesto. Lo segundo cuesta una corrección posterior, y a veces algo más.
Por qué cada campo debe llevar una etiqueta de origen
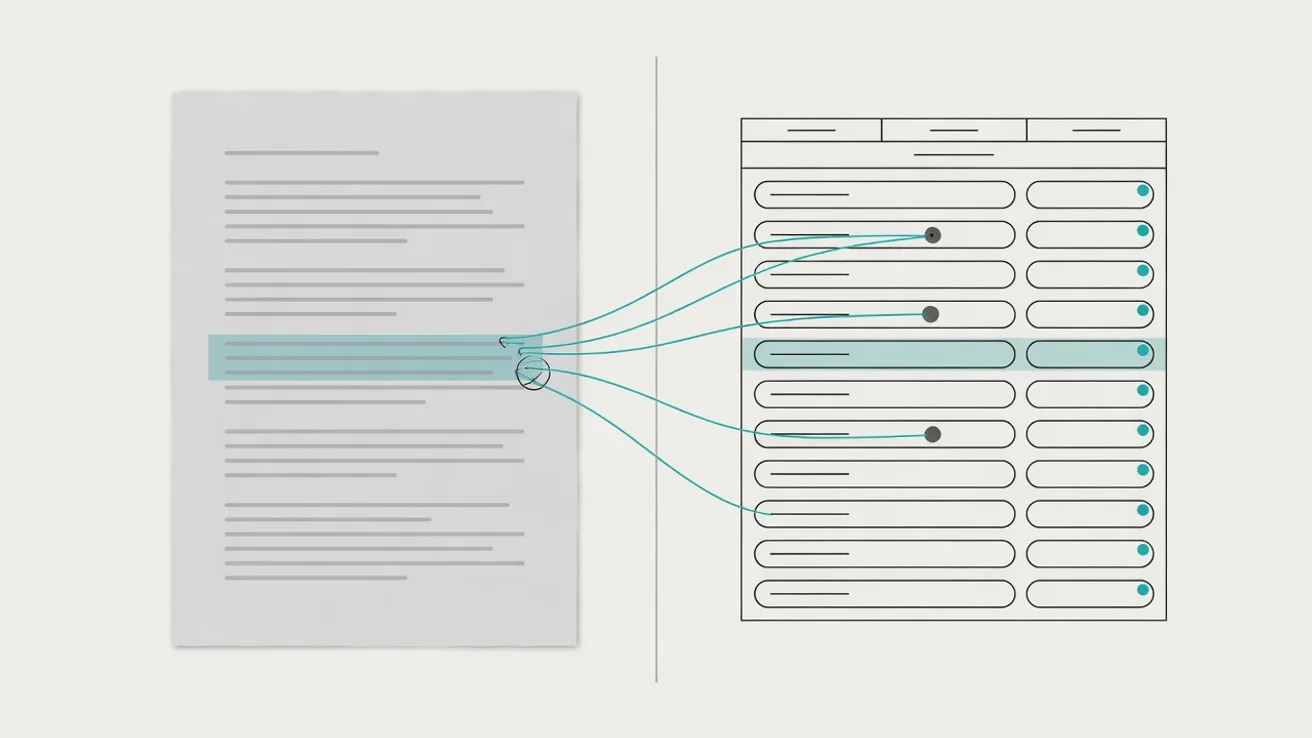
En cuanto acepta que un sistema se equivoca a veces, la pregunta deja de ser cómo excluir errores y pasa a ser cómo encontrarlos en segundos. Eso es un requisito de diseño, no un extra agradable. Cada campo extraído lleva una etiqueta hacia el documento del que procede y hacia el lugar exacto de la página, de modo que un clic coloca el fragmento junto al campo. La diferencia en el trabajo diario es grande. Sin etiqueta de origen, usted comprueba un total de factura abriendo el documento, buscando la página correcta, rastreando con la vista y comparando el importe. Con ella, la línea de la que procede el valor aparece junto al campo y usted confirma o corrige. Comprobar se convierte en mirar en lugar de teclear de nuevo. Esa misma cadena la necesitará después. En una auditoría debe poder mostrar de dónde sale un valor en aduana declarado: qué importe de factura, qué costes de transporte hasta el lugar de introducción en la Unión, qué tipo de cambio en qué momento. Un sistema que guarda la cifra pero no su procedencia le deja tirado justo en el momento en que se formula la pregunta.
Por qué clasificar no es un problema de extracción
La extracción y la clasificación se mencionan de un tirón y son cosas distintas. La extracción es una cuestión de hecho: ¿figura esto aquí? Clasificar es un juicio jurídico. Aplica usted las reglas de clasificación a una mercancía, pondera su naturaleza, su composición y su función, elige entre partidas que se excluyen entre sí, y pasa por un código SA que fija los seis primeros dígitos hasta llegar al código completo del que cuelga el tipo. De ese juicio cuelga la responsabilidad. El código determina el tipo, una posible preferencia, si se aplica un derecho antidumping y qué prohibiciones y restricciones vienen con él. Si está mal, sigue una liquidación a posteriori, y en representación indirecta acaba recayendo en usted. Quien quiere certeza solicita una IAV, y ese trámite existe precisamente porque la respuesta no se lee en el documento. El software puede ayudar aquí reduciendo el campo de búsqueda: cotejar la descripción con envíos anteriores, proponer el código que ya usó para este remitente y este artículo, y avisar cuando un código propuesto arrastra medidas que el expediente no cubre. Proponer y fundamentar. La decisión sigue siendo del declarante.
¿Para qué sirve entonces el humano en el circuito?
No para repasarlo todo otra vez. Quien vuelve a comprobar cada campo ha regalado el tiempo ganado y se queda con una pantalla más. El humano está para los puntos donde reside el juicio, y un lector bien construido lo empuja hacia ellos. Son tres cosas. Primero, los campos que el sistema no logra cerrar por sí mismo, con el documento de origen al lado, para que la decisión cueste segundos. Segundo, la contradicción entre documentos: la lista de empaque con doce líneas frente a una factura con once, la descripción del certificado que nombra una especie distinta de la factura. Una máquina puede señalar la diferencia, pero no decidir qué documento tiene razón, porque eso exige una llamada al remitente. Tercero, el juicio que corresponde al declarante: la clasificación, el valor en aduana bajo un acuerdo de precio poco habitual, la cuestión de si una prueba de origen encaja con este flujo de mercancías. Ese es exactamente el trabajo por el que tiene contratado a un declarante. La ganancia no está en sustituir ese juicio, sino en que deje de ahogarse en el tecleo de datos que ya existen en algún sitio en forma digital, incluso en una declaración de importación de lo más corriente.