·8 分钟阅读
在douane单证上,AI能做什么、不能做什么
如今这个市场上的每一家供应商都会说,自己的软件能读取您的单证。这话没错,但只在一定范围内成立。以下是诚实的版本:自动识读究竟解决了什么,在哪些地方会明确失效,以及为什么一套系统如何表达自己的不确定,比它一次做对的频率更重要。
软件说它会读您的单证,究竟指的是什么?
读单证并不是一个动作,而是三个动作,而且它们失败的方式各不相同。第一个是抽取:从 pdf 或扫描件中判断页面上有哪些字符,以及这些字符构成哪个字段。页面上写着 EUR 14.320,00 是一回事;这个数字是发票总额,而不是小计或者运费金额,是另一回事。 第二个是归类识别:判断手上拿到的是什么类型的单证,以及每一块文字各自扮演什么角色。送货单、形式发票和商业发票彼此相像,区别就藏在细节里,而这些细节在一种版式中排在页首,在另一种版式中排在页尾。 第三步在实务中省下的工作最多:把几份单证摆在一起互相比对。装箱单上的件数与发票行数是否一致。提单上的毛重与装箱单上的是否接近。证书引用的是不是同一个货运编号。这第三步已经不再是识读问题,而是计算和比较,而机器恰恰在这件事上不知疲倦,这一点是任何人在下午四点都做不到的。
自动识读在什么情况下毫不费力?
在枯燥的大多数上。一份由固定供应商的 ERP 生成、以带有真实文本层的 pdf 发出、每个月标题都在同一位置的商业发票,几乎就是一个恰好以单证形式传递的结构化文件。从 WMS 导出的装箱单,以及主管机关按固定模板签发的标准证书,也是同样的情况。 这些情况背后的共同点不是单证做得漂亮,而是重复。面对每周都能见到的发货人,系统知道贸易术语写在哪里,知道币种在右上角而不是紧挨着金额,知道 Ref. 在这家客户那里指采购订单号,在另一家那里指集装箱号。同一个发货人出现得越频繁,需要猜的地方就越少。 这同时也是这份承诺诚实的边界。自动识读在您已经熟悉的货流上表现良好,而这部分货流按票量算占据了您大部分工作日。它并不是您申报卡壳的那一部分,因为您的时间不花在那里。您的时间花在例外情况上。
它在哪些地方会明确失效?
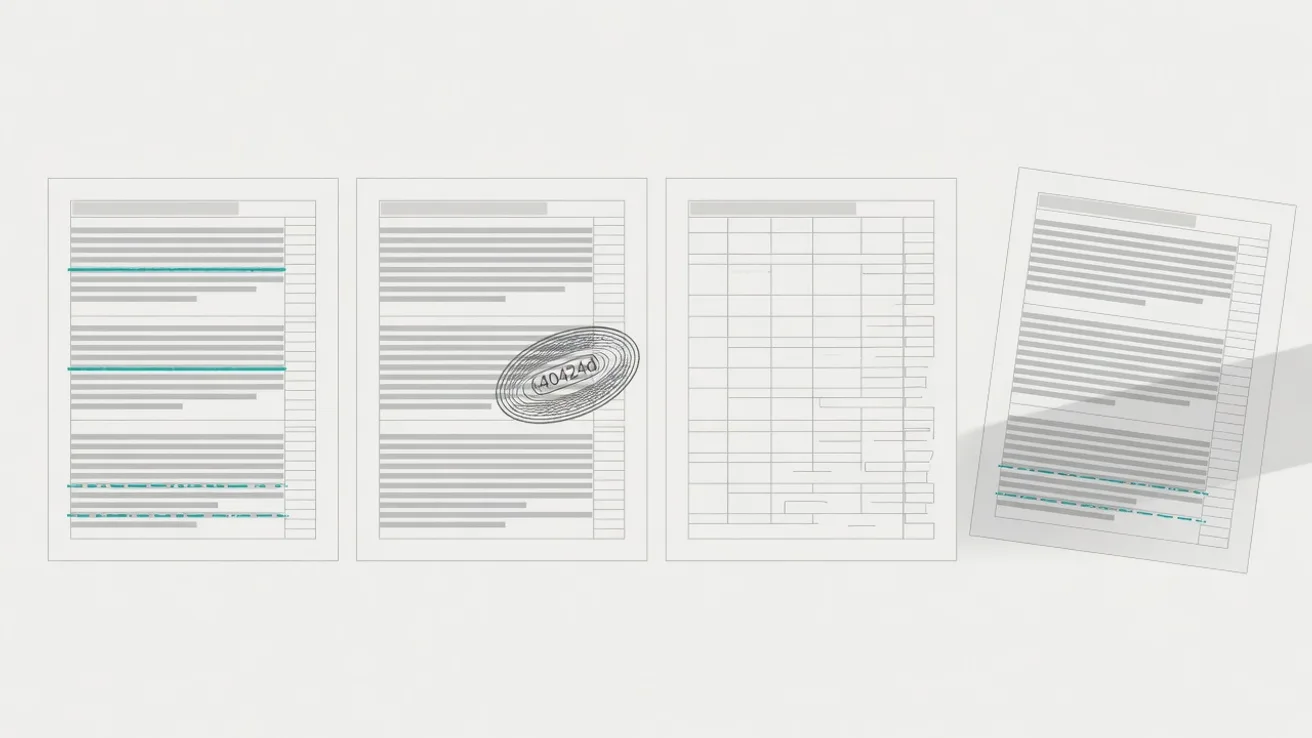
这份清单很具体,任何做申报的人都认得出来。手写字迹,比如在码头用笔补写上去的重量,或者一个签名加上下面那个让证书真正生效的日期。一份盖过章的单证,当年是传真件,之后又被复印、扫描、再次转发,印章正好压在您需要的那段文字上。 一份十一页的装箱单,行数加起来与发票上写的对不上。一张跨页继续的表格,换页之后表头不再重复,第三页最后一行和第四页第一行其实是同一行。两种语言混排的单证,上面是中文品名,下面是一段说法并不相同的英文。还有照片:有人用手机斜着拍下的一页,右侧栏被阴影盖住,一道折痕正好穿过金额。 这些情况的共同点在于,它们并不只是稍微难一点。它们是那种系统无论如何都必须给出答案时,会填进一个看上去合理的数值的情况。空着的字段谁都看得见,填得整整齐齐却填错的字段没人看得见。
为什么置信度分数不等于填对了
分数说明的是一个答案与模型此前见过的模式有多吻合。这与答案是否属实是两个问题。一张印刷工整的发票,如果某个金额落在了错误的栏位,系统恰恰会对这个错误金额给出很高的分数,因为形式是对的。分数衡量的是形式,不是事实。 这里存在一种不对称,设计时必须围绕它来做。一个被标记为不确定的字段,只花您二十秒,而且结果是好的。一个以高置信度填错的字段,会进入档案,经过那位信任它的同事,进入申报单,最终送到海关。带着把握出错,比不确定更昂贵。 因此真正有意思的问题不是系统多久对一次,而是它是否知道自己什么时候不知道,以及那时它会怎么做。一个在拿不准时宁可什么都不填、把字段留空的识读器,比一个总要填点什么的识读器更有用。前者的代价是多一个动作,后者的代价是事后更正,有时还不止如此。
为什么每个字段都必须带有来源标签
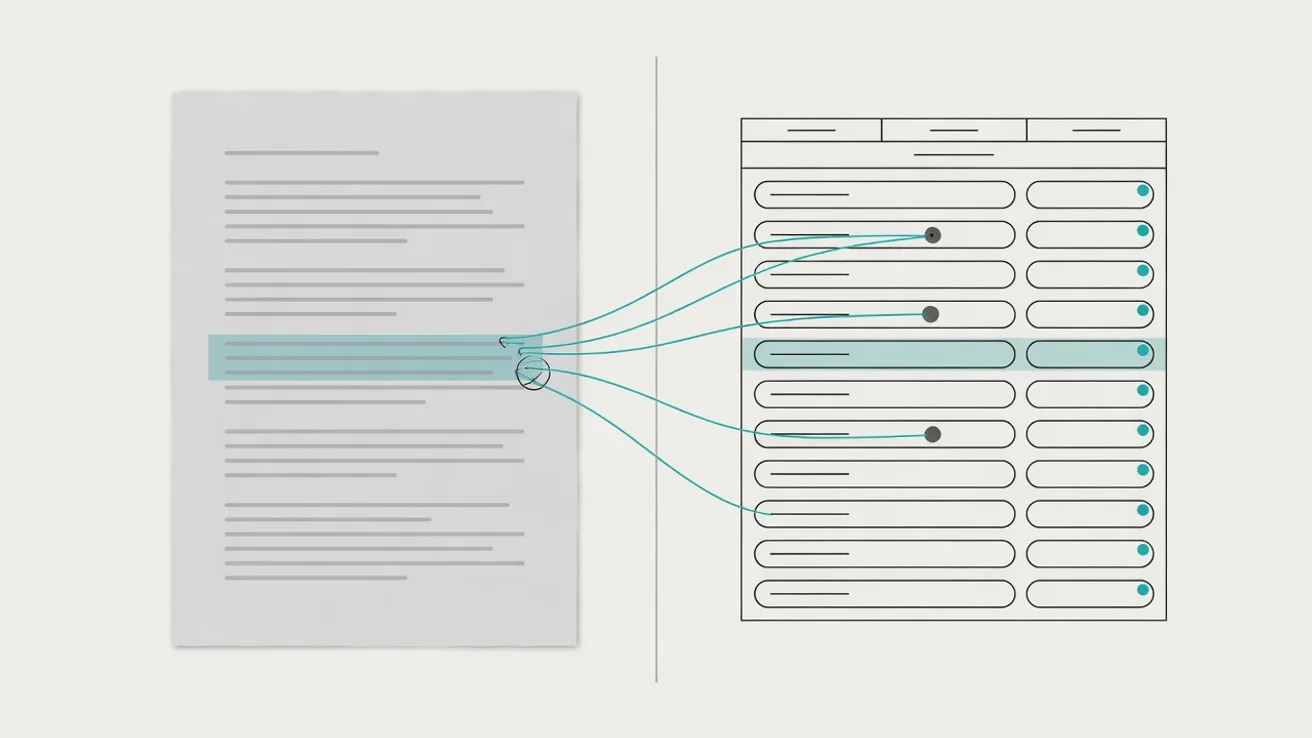
一旦您接受系统偶尔会出错,问题就不再是如何杜绝错误,而是如何在几秒钟之内找到它们。这是一项设计要求,而不是一个锦上添花的功能。每一个抽取出来的字段都带有标签,指回它所来自的单证以及页面上的具体位置,点一下就能把那一小块原文摆在字段旁边。 在日常工作里差别非常大。没有来源标签时,您核对一个发票总额要先把单证找出来,翻到正确的页面,用眼睛搜寻,再比对金额。有了来源标签,数值所在的那一行就摆在字段旁边,您只需确认或者更正。核对变成了看一眼,而不是重新录入。 同一条链路稍后还会用到。在事后稽查中,您必须能说明一个申报的完税价格是怎么来的:哪一笔发票金额,运至欧盟入境地点的哪一部分运费,哪个时点的哪个汇率。一套只保存数字却不保存来源的系统,恰恰会在问题被提出的那一刻把您撂在原地。
为什么商品归类不是一个识读问题
抽取和归类常被一口气放在一起讲,其实是两回事。抽取是事实问题:这里有没有写这个。归类是法律判断。您要把归类总规则适用到一件货物上,权衡它的性质、成分和功能,在互相排斥的品目之间做取舍,先经由确定前六位的 HS 编码,再落到挂着税率的完整编码上。 这个判断上挂着责任。编码决定税率、可能适用的优惠、是否征收反倾销税,以及随之而来的禁止和限制措施。一旦归错,就会有事后追征,而在间接代理之下,追征最终会落到您头上。想要确定性的人会去申请一份具有法律约束力的商品归类信息,而这套程序之所以存在,恰恰是因为答案没法从单证本身读出来。 软件在这里可以帮忙缩小范围:把品名与以往货物对照,提示您此前对同一发货人、同一物料使用过的编码,并在建议的编码带来档案未覆盖的措施时发出提醒。提出建议并给出依据。决定权仍在申报人手里。
那么人到底该待在流程的哪个位置?
不是把所有内容再看一遍。把每个字段都重新核对一遍的人,等于把省下来的时间又还了回去,最后只多了一块屏幕。人要处理的是需要判断的地方,而一套设计得当的识读器,会把人推到那些地方去。 具体是三类。第一类是系统自己收不了尾的字段,旁边就摆着原始单证,让这个决定只花几秒钟。第二类是单证之间的相互矛盾:装箱单十二行而发票只有十一行,证书上的品名写的品种与发票不同。机器可以指出这个差异,但没法判定哪一份单证是对的,因为那需要给发货人打一个电话。 第三类是本来就属于申报人的判断:商品归类,价格安排不寻常时的完税价格,某份原产地证明是否与这条货流相符。这正是您雇一名报关员来做的工作。真正的收益不在于替代这份判断,而在于让它不再淹没在重新录入的工作里,那些数据本来就已经以数字形式存在于某处,哪怕只是一份再普通不过的进口申报。