·10 min de lecture
Ce que l'IA sait faire, et ne sait pas faire, avec les documents douaniers
Tous les éditeurs de ce marché affirment désormais que leur logiciel lit vos documents. C'est vrai, jusqu'à un certain point. Voici la version honnête : ce que la lecture automatique résout réellement, où elle échoue de façon démontrable, et pourquoi la manière dont un système exprime son doute compte davantage que sa capacité à tomber juste du premier coup.
Que signifie vraiment le fait qu'un logiciel lise vos documents ?
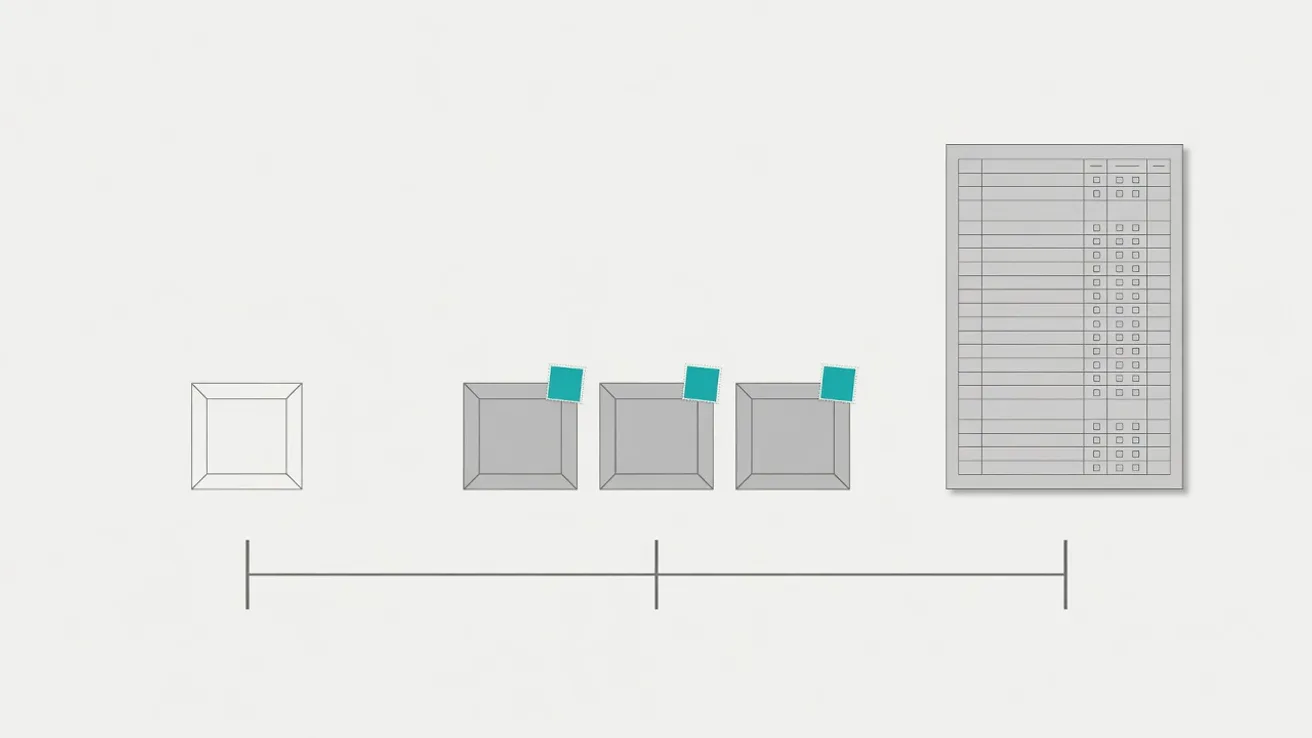
Lire des documents n'est pas une opération mais trois, et elles échouent différemment. La première est l'extraction : déduire d'un pdf ou d'un scan quels caractères figurent sur la page et quel champ ils composent. Que la page indique EUR 14 320,00 est une chose. Qu'il s'agisse du total de la facture et non du sous-total ou du montant du fret en est une autre. La deuxième est la classification : déterminer quel type de document vous avez en main et quel rôle joue chaque bloc de texte. Un bon de livraison, une facture proforma et une facture commerciale se ressemblent, et les différences tiennent à des détails qu'une mise en page place en haut et une autre en bas. La troisième étape est celle qui fait gagner le plus de temps en pratique : confronter les documents entre eux. Le nombre de colis de la liste de colisage correspond-il aux lignes de la facture. Le poids brut du connaissement est-il proche de celui de la liste de colisage. Le certificat renvoie-t-il au même numéro d'envoi. Cette troisième étape n'est plus un problème de lecture, c'est du calcul et de la comparaison, et c'est précisément là qu'une machine est infatigable comme personne ne l'est à seize heures.
Où la lecture automatique fonctionne-t-elle sans broncher ?
Sur l'ennuyeuse majorité. Une facture commerciale produite par l'ERP d'un fournisseur habituel, envoyée en pdf avec une véritable couche de texte, portant chaque mois les mêmes intitulés aux mêmes endroits, est presque un fichier structuré qui voyage par hasard sous forme de document. Il en va de même des listes de colisage issues d'un WMS et des certificats standard qu'une autorité délivre sur un modèle fixe. Le schéma commun à ces cas n'est pas la beauté du document, c'est la répétition. Chez un expéditeur que vous voyez chaque semaine, un système sait où figure l'incoterm, que la devise est en haut à droite et non à côté du montant, que Réf. désigne le numéro de commande chez cet acteur et le numéro de conteneur chez un autre. Plus un expéditeur revient, moins il reste à deviner. C'est aussi la limite honnête de la promesse. La lecture fonctionne bien sur le trafic que vous connaissez déjà, et ce trafic occupe en volume la plus grande partie de vos journées. Ce n'est pas la partie où vos déclarations se bloquent, car votre temps ne passe pas là. Votre temps passe dans les exceptions.
Où cela échoue-t-il de façon démontrable ?
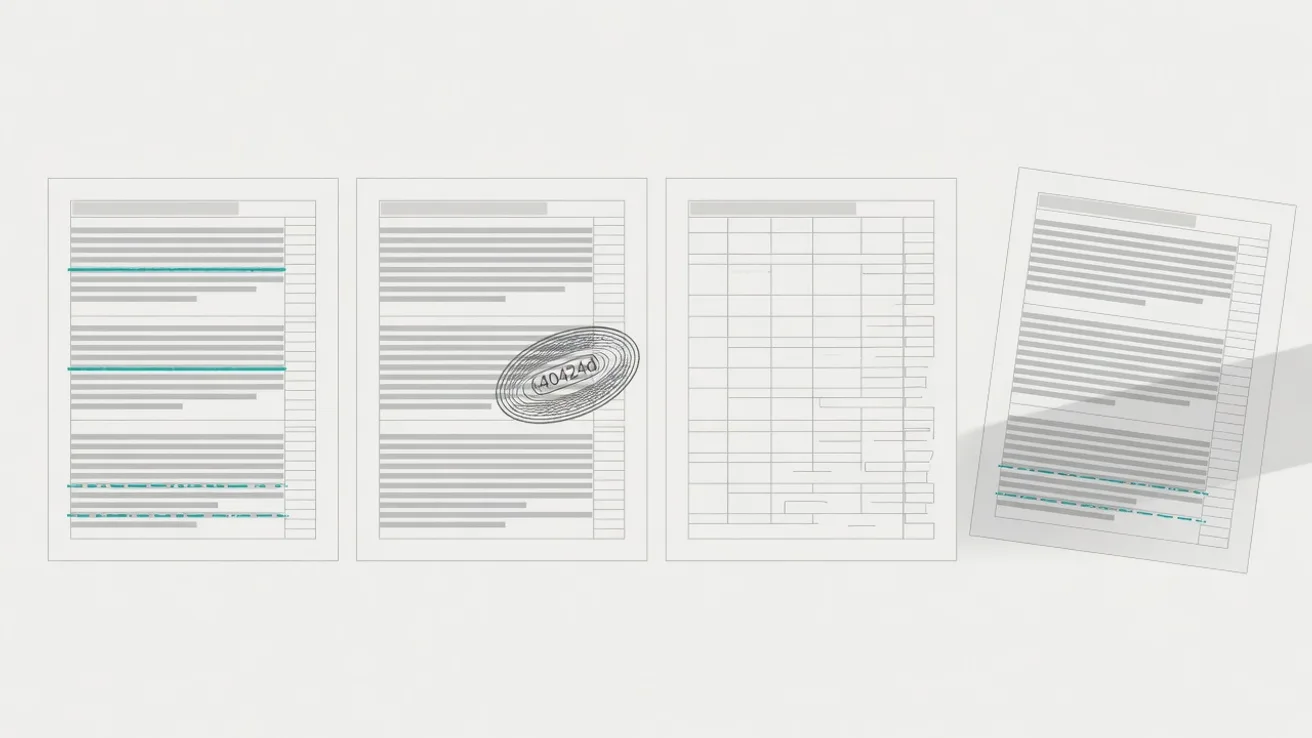
La liste est concrète et tous ceux qui déposent des déclarations la reconnaissent. L'écriture manuscrite, par exemple un poids ajouté au stylo sur le quai, ou une signature suivie d'une date qui rend seulement le certificat valable. Un document tamponné qui fut un fax, ensuite photocopié, scanné puis retransmis, le tampon retombant en plein sur le texte dont vous avez besoin. Une liste de colisage de onze pages dont le nombre de lignes ne correspond pas à ce que dit la facture. Un tableau qui se poursuit après un saut de page, sans répétition des en-têtes, où la dernière ligne de la page trois et la première de la page quatre ne forment en réalité qu'une seule ligne. Des documents mêlant deux langues, avec une désignation en chinois et une autre en anglais en dessous qui ne dit pas la même chose. Et la photo : une page saisie de travers au téléphone, avec une ombre sur la colonne de droite et un pli en travers du montant. Ces cas ont ceci en commun qu'ils ne sont pas seulement un peu plus difficiles. Ce sont ceux où un système contraint de fournir une réponse remplit quelque chose de plausible. Un champ vide, tout le monde le voit. Un champ faux mais proprement rempli, personne.
Pourquoi un score de confiance n'équivaut pas à un résultat juste
Un score indique dans quelle mesure une réponse correspond aux schémas déjà vus par le modèle. C'est une autre question que celle de sa véracité. Une facture proprement imprimée, dont un montant se trouve dans la mauvaise colonne, produit un score élevé sur ce montant erroné précisément, car la forme est correcte. Le score mesure la forme, pas la réalité. C'est là l'asymétrie autour de laquelle il faut concevoir. Un champ signalé comme incertain vous coûte vingt secondes et se termine bien. Un champ faux avec une confiance élevée entre dans le dossier, passe devant le collègue qui s'y fie, entre dans la déclaration et finit chez la douane. Faux avec assurance coûte plus cher qu'incertain. La vraie question n'est donc pas de savoir à quelle fréquence un système tombe juste, mais s'il sait quand il ne sait pas, et ce qu'il fait alors. Un lecteur qui préfère ne rien remplir en cas de doute et laisser le champ ouvert est plus utile qu'un lecteur qui remplit toujours quelque chose. Le premier coûte un geste. Le second coûte une correction après coup, et parfois davantage.
Pourquoi chaque champ doit porter une étiquette de source
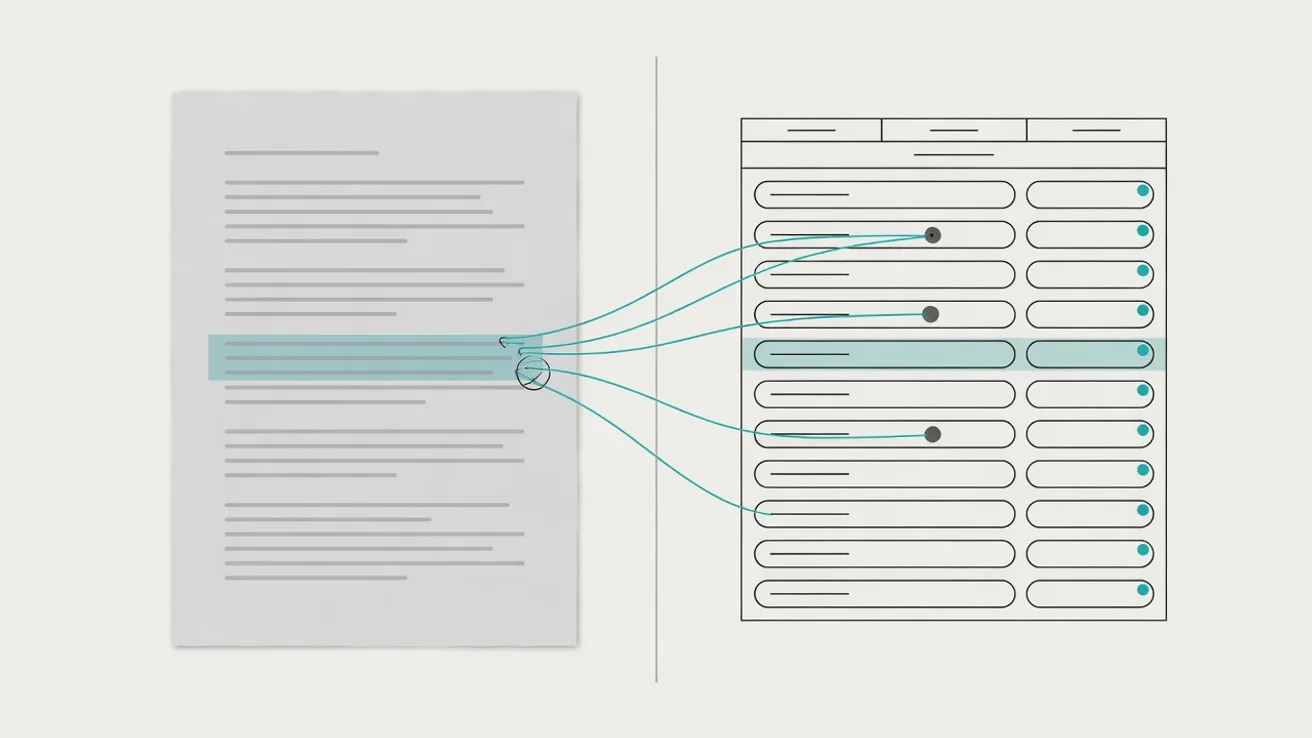
Dès lors que vous admettez qu'un système se trompe parfois, la question n'est plus d'exclure les erreurs mais de les retrouver en quelques secondes. C'est une exigence de conception, pas une option agréable. Chaque champ extrait porte une étiquette vers le document dont il provient et vers l'endroit précis de la page, de sorte qu'un clic place l'extrait à côté du champ. La différence au quotidien est considérable. Sans étiquette de source, vous vérifiez un total de facture en ouvrant le document, en trouvant la bonne page, en cherchant des yeux et en comparant le montant. Avec elle, la ligne d'où vient la valeur s'affiche à côté du champ et vous confirmez ou vous corrigez. Vérifier devient regarder au lieu de ressaisir. Vous aurez besoin de cette même chaîne plus tard. Lors d'un contrôle a posteriori, vous devez pouvoir montrer d'où vient une valeur en douane déclarée : quel montant de facture, quels frais de transport jusqu'au lieu d'introduction dans l'Union, quel taux de change à quel moment. Un système qui conserve le chiffre mais pas son origine vous abandonne exactement au moment où la question est posée.
Pourquoi le classement tarifaire n'est pas un problème d'extraction
L'extraction et le classement sont souvent cités d'un même souffle et ce sont deux choses distinctes. L'extraction est une question de fait : cela figure-t-il ici. Le classement est un jugement juridique. Vous appliquez les règles de classement à une marchandise, vous pesez sa nature, sa composition et sa fonction, vous tranchez entre des positions qui s'excluent, et vous passez par un code SH qui fixe les six premiers chiffres avant d'aboutir au code complet auquel se rattache le taux. Une responsabilité s'attache à ce jugement. Le code détermine le taux, une éventuelle préférence, l'application d'un droit antidumping et les prohibitions et restrictions qui suivent. S'il est faux, un recouvrement a posteriori arrive, et en représentation indirecte il atterrit chez vous. Qui veut de la certitude demande un RTC, et cette procédure existe précisément parce que la réponse ne se lit pas sur le document. Le logiciel peut aider ici en réduisant le champ de recherche : rapprocher la désignation d'envois antérieurs, proposer le code déjà utilisé pour cet expéditeur et cet article, et alerter lorsqu'un code proposé entraîne des mesures que le dossier ne couvre pas. Proposer et étayer. La décision reste au déclarant.
À quoi sert alors vraiment l'humain dans la boucle ?
Pas à tout revérifier. Celui qui contrôle à nouveau chaque champ a rendu le temps gagné et se retrouve avec un écran de plus. L'humain est là pour les endroits où se loge le jugement, et un lecteur bien conçu l'y pousse. Cela recouvre trois choses. D'abord les champs que le système ne parvient pas à clore seul, avec le document source à côté, pour que la décision prenne quelques secondes. Ensuite les contradictions entre documents : la liste de colisage à douze lignes face à une facture qui en compte onze, la désignation du certificat qui nomme une autre espèce que la facture. Une machine peut désigner l'écart, mais pas décider quel document a raison, car cela demande un appel à l'expéditeur. Enfin le jugement qui revient au déclarant : le classement, la valeur en douane sous un arrangement de prix inhabituel, la question de savoir si une preuve d'origine convient à ce flux de marchandises. C'est exactement le travail pour lequel vous employez un déclarant. Le gain n'est pas de remplacer ce jugement, mais d'éviter qu'il se noie dans la ressaisie de données déjà présentes quelque part sous forme numérique, y compris sur une déclaration d'importation tout à fait ordinaire.